Kimi K3 løste opgaven billigere end GLM 5.2. Bagefter åbnede jeg sessionen og så, hvad den egentlig havde lavet.
Først gav jeg GLM 5.2 en opgave i OpenCode: Lav en LinkedIn-karrusel om, hvor nemt det er at starte modellen gennem pks-cli. Da den var færdig, bad jeg den også skrive dokumentationen til agentics.dk/tools.
Et par dage senere gav jeg Kimi K3 de samme to prompts. Da jeg regnede efter, havde Kimi-forløbet kostet cirka $2,44 mod GLM's $6,91.
Min første antagelse var, at Kimi simpelthen var den billigere model. Det var forkert. Moonshots almindelige Kimi-input kostede $3/M mod GLM's $1,80/M, og Kimi-output kostede $15/M mod GLM's $5,50/M. En model med højere listepriser blev alligevel billigst, fordi agenten kunne genbruge arbejdet og ramte Moonshots input-cache.
Så kiggede jeg i OpenCode-sessionen.
Kimi havde fundet GLM's færdige karrusel i repositoryet.
De fik samme opgave
GLM fik denne rå prompt, gengivet præcis som den blev skrevet:
Kimi fik samme opgave med model, provider og commit skiftet ud:
Begge fik derefter den samme followup:
Det var ikke planlagt som en videnskabelig benchmark. Men jeg forventede alligevel, at Kimi ville løse opgaven nogenlunde selvstændigt ud fra koden og den eksisterende designstruktur.
Det var ikke helt det, der skete.
Den fandt den perfekte skabelon
Kimi startede fornuftigt: Den læste repositoryet, fandt committen og undersøgte de eksisterende marketing-assets.
Så noterede den i sit ræsonnement:
There's a previous carousel
marketing/linkedin/opencode-glm-5-2-scalewaywhich is the previous version of this exact same story. Let me look at how that's structured — it's the perfect template for this new carousel.
Derefter læste den direkte:
- GLM-karrusellens
carousel.html - dens
build.mjs - LinkedIn-opslagsteksten
- preview-siden
Og så byggede den en Kimi-version med samme mappestruktur, samme build-flow, samme syv slides og samme visuelle system.
Samme opgave, to karuseller
Skift slide for at sammenligne GLM 5.2 og Kimi K3 side om side.
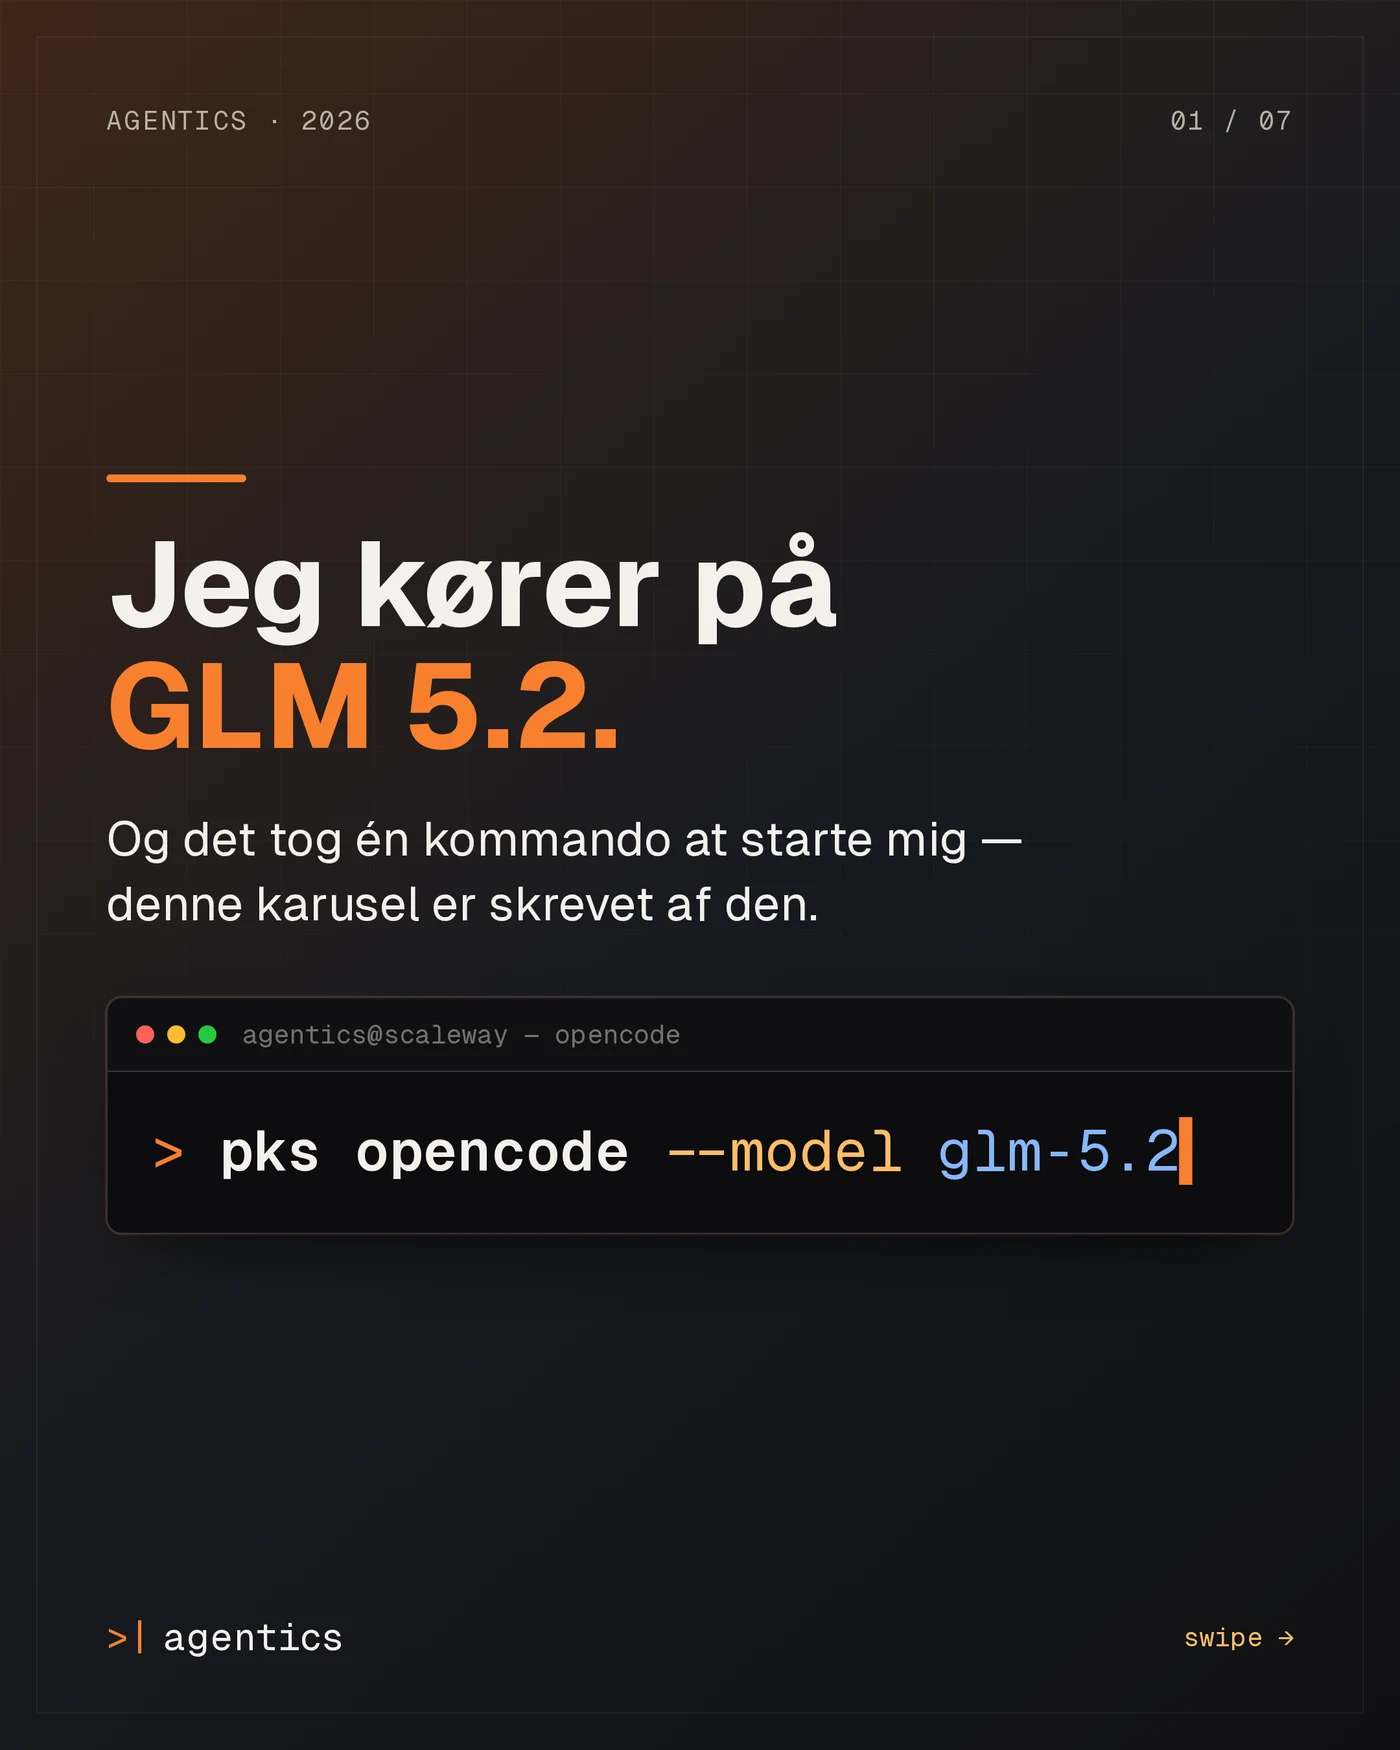
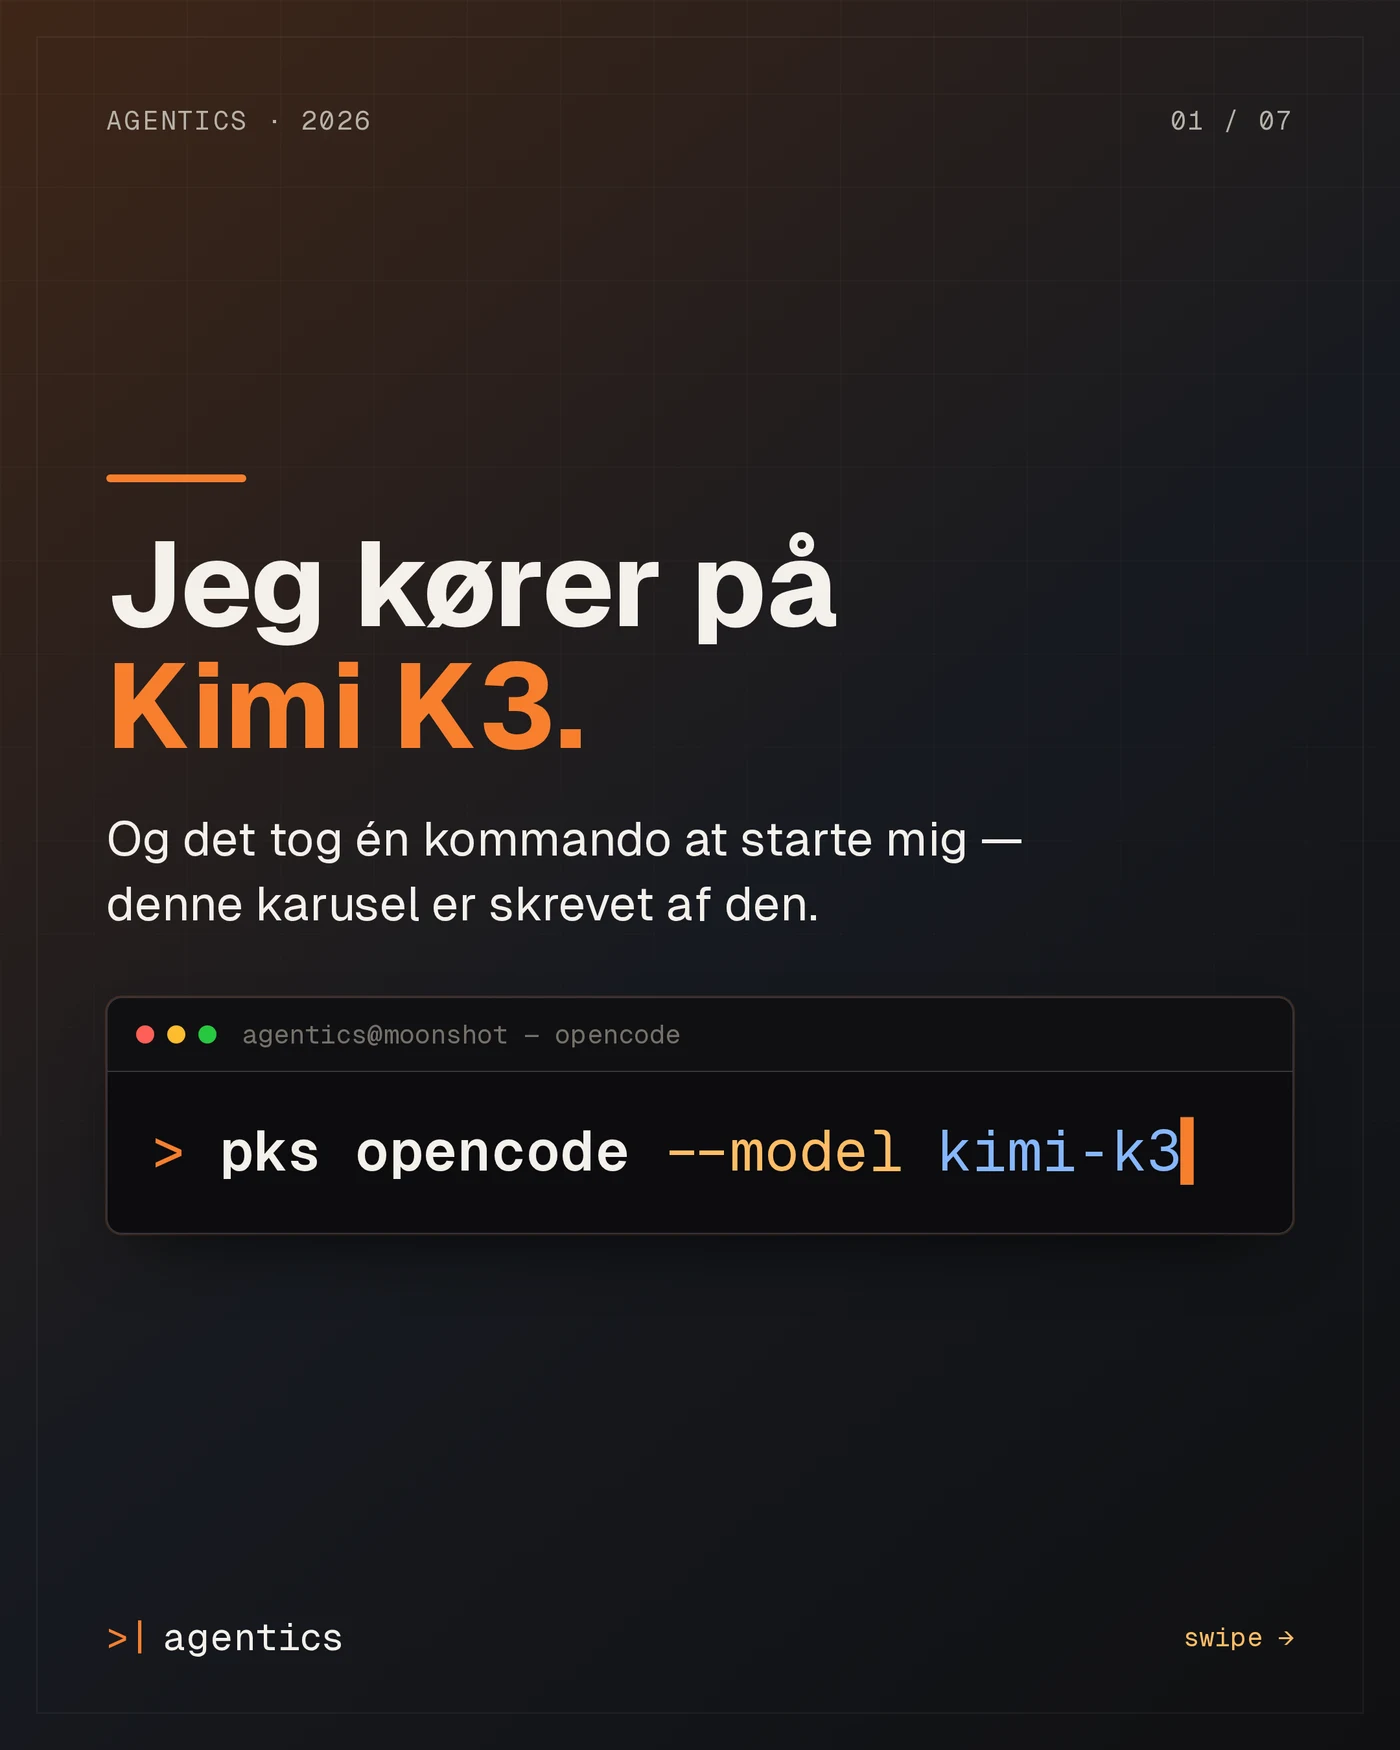
En almindelig linjevis diff gør genbruget tydeligt:
| Fil | Linjer | Ændrede linjer |
|---|---|---|
carousel.html | 327 | 31 |
build.mjs | 114 | 29 |
linkedin.da.md | 43 | 17 |
preview.html | 54 | 2 |
På tværs af de fire filer var cirka 85 procent af linjerne byte-for-byte uændrede. Det tal skal ikke oversælges: Meget af det er CSS, rendering og anden boilerplate, som netop bør genbruges. Men Kimi skabte ikke en uafhængig visuel løsning. Den lavede en kompetent tilpasning af GLM's arbejde.
Den dyrere model leverede den billigste kørsel
OpenCode kendte ikke Kimi K3's priser og viste derfor $0. Sessionen havde dog gemt alle token-tal, så forbruget kunne beregnes med Moonshots priser for cache-hit input, almindeligt input og output.
Det var en lidt pudsig forskel i selve forsøget: Med GLM kunne jeg se dollartælleren vokse direkte i OpenCode. Med Kimi viste tælleren nul, selv om Moonshot naturligvis stadig trak forbruget fra min konto. Jeg måtte derfor eksportere sessionen og regne efter på de gemte tokens.
Det OpenCode viste — og det sessionerne faktisk kostede
Samme forløb: LinkedIn-karrusel og efterfølgende dokumentation.
Kimi K3
Moonshot · 70 modelkald
Beregnet fra sessionen
$2.44
$3/M almindeligt input · $0.30/M cache-hit input · $15/M output og reasoning
GLM 5.2
Scaleway · 55 modelkald
Beregnet fra sessionen
$6.91
$1.80/M input · $5.50/M output. OpenCode havde GLM-priserne i sit modelkatalog og kunne derfor vise prisen løbende.
Den orange bjælke viser andelen af input, der blev leveret fra cachen. For Kimi var det 97,8 procent; GLM-forløbet registrerede ingen cache-hit input.
| Opgave | Kimi K3 | GLM 5.2 |
|---|---|---|
| Karussel | ca. $0,84 | ca. $2,77 |
| Dokumentation | ca. $1,60 | ca. $4,14 |
| Samlet | ca. $2,44 | ca. $6,91 |
GLM-tallet inkluderer den underagent, der hentede kontekst fra den oprindelige Codex-session. Kimi lavede altså flere modelkald — 70 mod 55 — men sendte kun 113.347 almindelige input-tokens. Yderligere 4.954.624 input-tokens ramte Moonshots cache og kostede en tiendedel af den almindelige inputpris.
Kimi var altså 67 procent dyrere på almindeligt input og næsten tre gange så dyr på output. Det billige element var cache-hit input til $0,30/M. Den konkrete kørsel blev billigere, fordi næsten 98 procent af dens input ramte den cache, og fordi agenten kunne genbruge det arbejde, GLM allerede havde lagt i repositoryet.
En model med højere listepriser kan stadig være billigst til opgaven, hvis agentens arbejdsform reducerer mængden af dyrt arbejde.
Det er stadig nyttige driftstal. Hvis jeg giver Kimi en opgave i et repository med et nært beslægtet eksempel, kostede den konkrete opgave cirka $2,44.
Men tallene siger ikke, at Kimi er 65 procent bedre eller billigere til at skabe en karrusel og dokumentation fra bunden. Den havde adgang til en løsning, GLM ikke havde adgang til.
Jeg benchmarkede ikke to isolerede modeller. Jeg observerede to agenter på forskellige tidspunkter i et repository, der havde fået mere hukommelse mellem første og andet forsøg.
Det er en fejl i et benchmark — og en styrke i arbejdet
Hvis formålet var en ren benchmark, var forsøget forurenet. Jeg skulle have brugt to rene worktrees, skjult den første models output og givet begge en ny, men tilsvarende opgave.
Men det er ikke sådan, jeg normalt ønsker, at en coding agent arbejder.
I et rigtigt repository forventer jeg, at agenten:
- leder efter eksisterende løsninger,
- genbruger design og etablerede mønstre,
- undgår at opfinde endnu et build-flow,
- tilpasser tidligere arbejde til den nye opgave,
- verificerer resultatet.
Kimi “snød” kun, hvis opgaven var at bevise sin egen kreativitet under laboratorieforhold. Opgaven var i virkeligheden at levere en karrusel og dokumentation, der passede ind i et eksisterende produkt. Til det formål gjorde den det rigtige.
Det interessante er derfor ikke, hvilken model der vandt. Det interessante er, hvor meget bedre agenter bliver, når repositoryet allerede indeholder gode eksempler, dokumentation og tidligere artefakter.
pks-cli er indgangen, ikke dommeren
Jeg bygger ikke pks-cli for at kåre én model som den bedste. Jeg bygger det for at gøre det nemt at starte den agent og model, der passer til opgaven.
GLM-forløbet startede sådan:
pks opencode --model glm-5.2
Kimi-forløbet startede sådan:
pks moonshot init
pks opencode --model kimi-k3
pks-cli finder provideren ud fra modellen, genbruger de credentials, der allerede er registreret, og starter det rigtige værktøj uden at lægge secrets i argumentlisten eller skrive dem ind i OpenCodes konfiguration.
Det gør ikke eksperimentet videnskabeligt. Det gør det nemt at lave eksperimentet — og bagefter bruge den model, der faktisk løser arbejdet bedst i den kontekst, den får.
Sig endelig til, hvis du savner en bestemt agent, model eller provider i pks-cli.
Foreslå en agent, model eller provider →
Du kan også se den aktuelle opsætning i pks opencode-dokumentationen.